Visuelle Qualitätskontrolle in der Produktion
Erkennt Fehler anhand von Bildern der Produkte am Band und senkt so die Belastung der Bediener und die Quote übersehener Fehler.
Künstliche Intelligenz
Wir entwickeln KI-Systeme speziell für Ihr Unternehmen, die aus Daten Entscheidungen machen.
Das größte Risiko in KI-Projekten ist, die Technologie vor dem Problem zu wählen. Bei DGH Ar-Ge analysieren wir zuerst das geschäftliche Problem und die vorhandenen Daten wissenschaftlich, definieren ein messbares Ziel und gehen dann mit Prototyp und Messung vor.
Dank unseres akademischen Teams stützen wir Modellauswahl, Datenaufbereitung und Validierung auf Belege statt auf Vermutungen. Die Lösung wird als nachvollziehbares, nachhaltiges System übergeben, das per API an Ihre bestehende Software angebunden ist.
Ausführlich
Viele Organisationen beginnen ein KI-Projekt mit der Frage „Welchen Algorithmus sollen wir verwenden?“. Die richtige Frage lautet aber: „Welche Entscheidung oder welcher Prozess würde unser Geschäft messbar verändern, wenn er besser wäre?“ Bei DGH Ar-Ge beginnen wir damit, das Geschäftsziel an eine Kennzahl zu knüpfen: sinkende Fehlerquote, kürzere Prüfzeit, höhere Prognosegenauigkeit und Ähnliches.
Steht dieses Ziel fest, prüfen wir, ob Ihre Daten es tragen. Reichen die Daten nicht aus, ist es weit günstiger, das Projekt zu stoppen oder zuerst eine Datenerfassung aufzubauen, als Monate in das falsche Modell zu stecken. Hier zeigt sich der Wert der wissenschaftlichen Methode: Wir investieren nicht, ohne die Annahme zu testen.
Datenaufbereitung, Feature Engineering, Modellauswahl und Hyperparameter-Tuning laufen als disziplinierter Versuchsprozess. Jedes Experiment wird dokumentiert – so sind die Ergebnisse reproduzierbar und es ist nachvollziehbar, warum ein bestimmtes Modell gewählt wurde.
Bei der Validierung schauen wir nicht nur auf eine einzige Erfolgsquote. Klassenungleichgewicht, Grenzfälle, die Kosten verschiedener Fehlerarten und die Robustheit gegenüber Daten-Drift in der Praxis werden getrennt gemessen. Ein Modell, das im Einsatz Fehlalarme auslöst, ist nutzlos – auch wenn es auf dem Papier eine hohe Genauigkeit zeigt.
Das trainierte Modell wird als REST-Service oder Batch-Job verpackt und an Ihre bestehende Software angebunden. So sehen Mitarbeitende intelligentere Ergebnisse in vertrauten Oberflächen, statt ein neues Werkzeug lernen zu müssen.
Im Betrieb wird die Modellleistung überwacht; ändert sich die Datenverteilung, gibt es eine Warnung, und bei Bedarf wird ein Nachtraining eingeplant. Wer für das Modell verantwortlich ist, wann es aktualisiert wird und was im Fehlerfall zu tun ist, wird dokumentiert.
Geltungsbereich
Modelle für Klassifikation, Prognose und Anomalieerkennung – trainiert und validiert mit Ihren Geschäftsdaten.
Bildbasierte Automatisierung wie Qualitätskontrolle, Zählung, Erkennung und Messung.
Verstreute Daten sammeln, bereinigen und in Dashboards verständlich machen.
Lösungen für Textklassifikation, Zusammenfassung und Dokumentenverständnis.
Modelle zur Planungsunterstützung, etwa Bedarfs-, Bestands- und Ausfallprognosen.
Die Modelle werden per REST-API an Ihre bestehenden ERP-, Web- und Mobilanwendungen angebunden.
Problem → Lösung
Wir haben viele Daten, wissen aber nicht, wofür sie nützlich sind.
Wir erfassen Ihre Datenbestände, gleichen sie mit dem Geschäftsziel ab und bestimmen den ersten Anwendungsfall mit dem höchsten Nutzen.
Manuelle Prüfungen sind langsam und fehleranfällig.
Wir automatisieren die Prüfung mit Bildverarbeitungs- und Klassifikationsmodellen und leiten nur Verdachtsfälle an Menschen weiter.
Bestands- und Bedarfsplanung beruht auf Schätzungen.
Wir entwickeln aus historischen Daten Bedarfsprognosemodelle und unterstützen Planung und Einkauf datenbasiert.
Prozess
Geschäftsproblem, Erfolgskennzahl und Datenquellen werden festgelegt.
Ergebnis: Bericht zur Ziel- und DatenbewertungDaten werden gesammelt, bereinigt und annotiert.
Ergebnis: Aufbereiteter Datensatz und DatenkatalogMehrere Modelle werden verglichen und die Ergebnisse gemessen.
Ergebnis: Versuchsbericht und PrototypDas Modell wird als API bzw. Service an Ihre Systeme angebunden.
Ergebnis: Live-Service und IntegrationsdokumentationDie Leistung wird überwacht und das Modell bei Bedarf neu trainiert.
Ergebnis: Monitoring-Dashboard und WartungsplanAnwendungsfälle
Erkennt Fehler anhand von Bildern der Produkte am Band und senkt so die Belastung der Bediener und die Quote übersehener Fehler.
Unterstützt Einkaufsentscheidungen, indem Verkaufshistorie, Saisonalität und Kampagneneffekte gemeinsam ausgewertet werden.
Leitet eingehende E-Mails, Formulare und Dokumente automatisch nach Thema und Dringlichkeit weiter.
Worauf zu achten ist
Zuerst das Modell wählen
Richtig ist: erst Ziel und Daten – das Modell ergibt sich aus diesen beiden.
Nur auf die Genauigkeit in Prozent schauen
Richtig ist: die Kosten der einzelnen Fehlerarten und das Verhalten mit echten Praxisdaten messen.
Nach dem Livegang nicht überwachen
Richtig ist: Daten-Drift überwachen und Nachtrainings einplanen.
Mehr erfahren
Portfolio
Ein Bildverarbeitungssystem an der Prüfstation eines Metallteileherstellers erkennt Oberflächenfehler in Bandgeschwindigkeit.
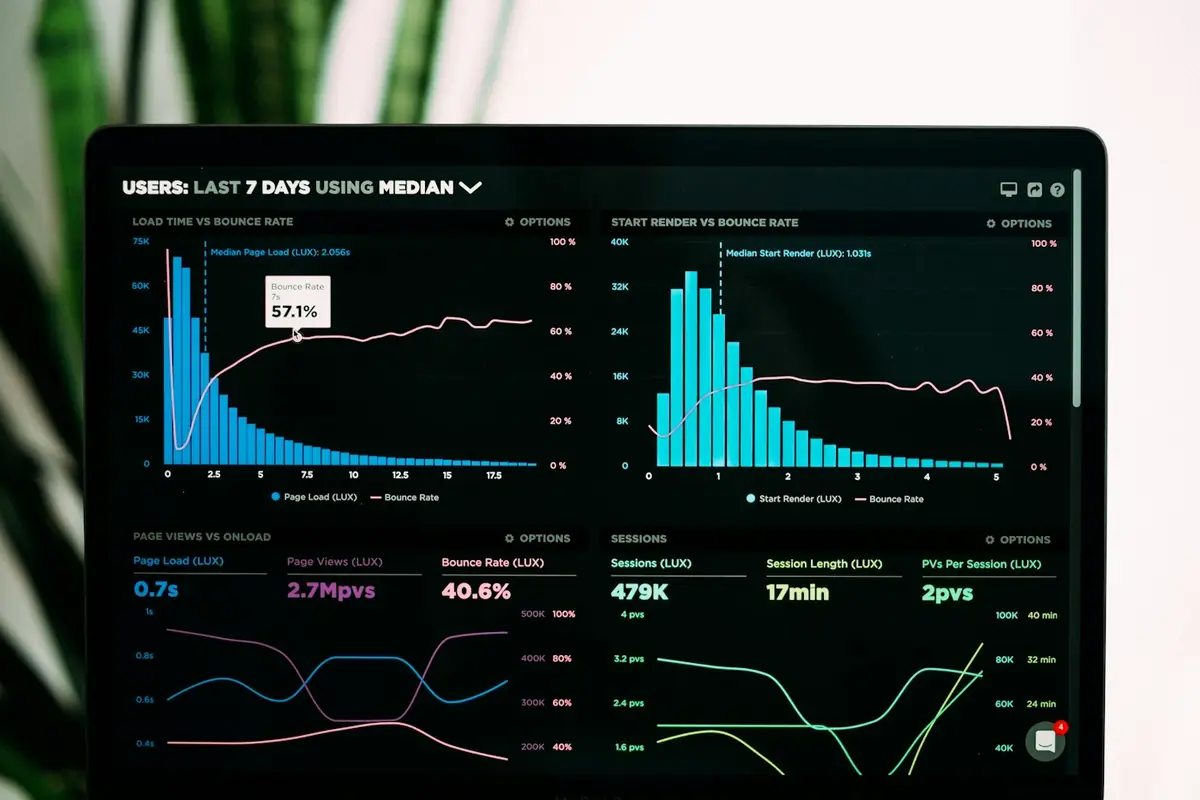
−%38 Fehlerhafte Teile im VersandProjekt ansehen KI-AnwendungenEinzelhandel und Distribution · 2025Für einen Händler mit mehreren Lagern haben wir ein Modell entwickelt, das aus der Absatzhistorie wöchentliche Bedarfsprognosen erstellt und Bestellungen vorschlägt.
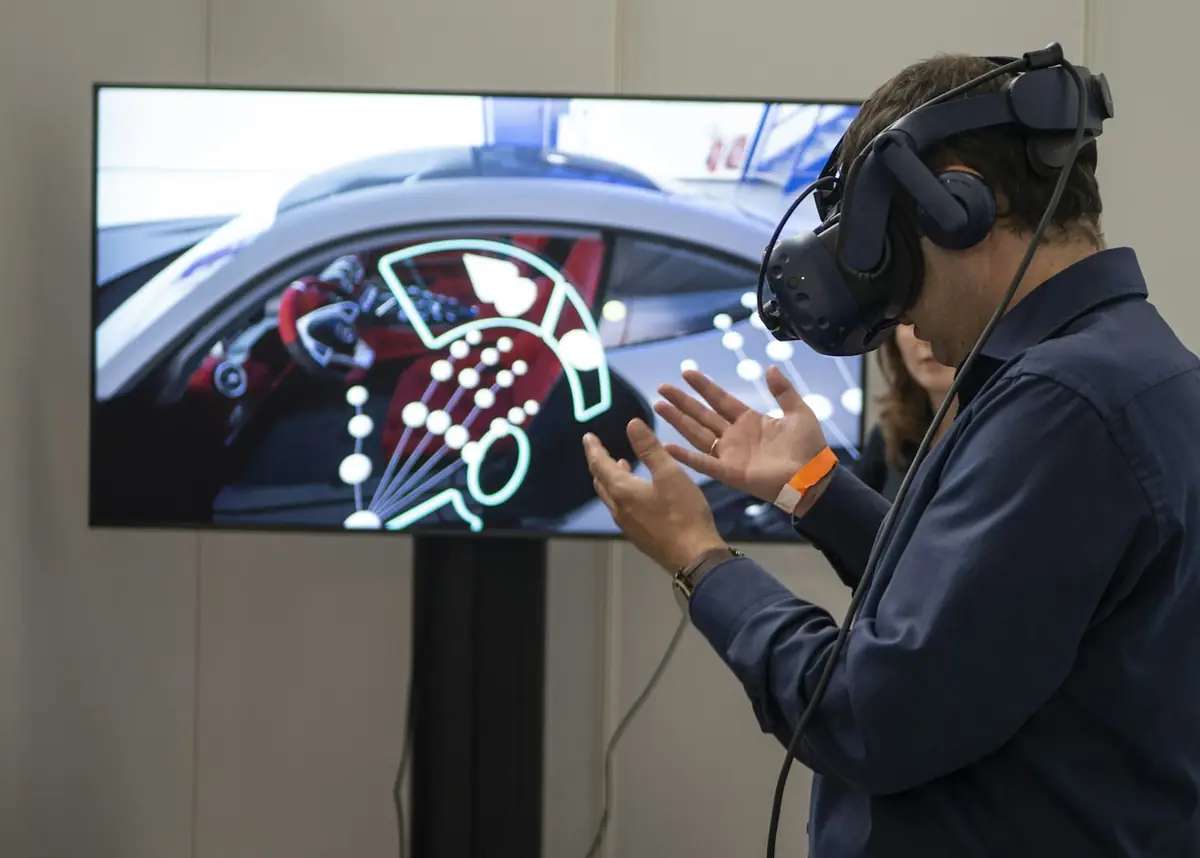
−%27 Anzahl der FehlbeständeProjekt ansehen VR- / AR-AnwendungenIndustrie und Schulung · 2026Eine VR-Schulungssimulation, die gefährliche Arbeitsumgebungen sicher erlebbar macht und den Lernerfolg misst.
+%40 Wissensbehalt (Beispiel)Projekt ansehenFAQ
Die benötigte Datenmenge hängt vom Problem ab. Im ersten Gespräch prüfen wir die vorhandenen Daten und klären gemeinsam Machbarkeit und zusätzlichen Datenbedarf.
Ja. Die von uns entwickelten Modelle binden wir per API in Ihre ERP-, Web- und Mobilanwendungen ein.
Ja. Gemäß der wissenschaftlichen Methode empfehlen wir zuerst einen kleinen Prototyp mit Messung und skalieren dann anhand der Ergebnisse.
Das hängt vom Umfang ab. Erkundung und Prototyp dauern meist einige Wochen, Livegang und Integration weitere Wochen bis Monate. Einen festen Zeitplan nennen wir nach der Datenbewertung.
Die Datensicherheit richtet sich nach Ihrem Bedarf; das Modell kann in Ihrer eigenen Infrastruktur oder in einer kontrollierten Cloud-Umgebung laufen. Vertraulichkeitsbedingungen werden vertraglich geregelt.
Allgemeine Dienste reichen für viele Aufgaben aus. Bei unternehmensspezifischen Daten, Vertraulichkeits- oder Genauigkeitsanforderungen ist ein eigenes Modell oder eine Anpassung sinnvoller; wir wägen beides gemeinsam nach Kosten und Nutzen ab.
Künstliche Intelligenz ist ein breites Feld mit dem Ziel, Maschinen Aufgaben erledigen zu lassen, die Intelligenz erfordern. Maschinelles Lernen ist ein Teilgebiet davon: Modelle lernen aus Daten, statt dass Regeln von Hand geschrieben werden. Die meisten Unternehmensprojekte beruhen auf Verfahren des maschinellen Lernens wie Klassifikation, Prognose und Anomalieerkennung.
Erfolg wird an Geschäftskennzahlen gemessen, die vor Projektbeginn festgelegt werden – etwa sinkende Fehlerquote, eingesparte Zeit, Prognosegenauigkeit oder Kostensenkung. Modellleistung (Accuracy, Precision, Recall) und geschäftlicher Nutzen werden getrennt berichtet, damit technischer Erfolg nicht mit tatsächlichem Nutzen verwechselt wird.
Ändert sich die Datenverteilung, kann die Modellleistung sinken. Deshalb werden produktive Modelle überwacht, bei Leistungsabfall gibt es Warnungen, und bei Bedarf wird mit neuen Daten nachtrainiert. Der Wartungs- und Nachtrainingsplan wird mit der Übergabe schriftlich übergeben.
Ja. Wir entwickeln etwa Assistenten, die auf Basis Ihrer Wissensdatenbank antworten, sowie Lösungen für Dokumentzusammenfassung und Inhaltsklassifikation. Entscheidend sind dabei Datenschutz, quellenbasierte Antworten und die Kontrolle fehlerhafter Antworten. Diese Punkte klären wir zu Beginn des Designs.
Es genügen eine Fachverantwortliche bzw. ein Fachverantwortlicher, die das Geschäftsproblem kennt, und eine technische Ansprechperson für den Datenzugang. Data Science und Engineering übernehmen wir. Dass Entscheider an den Zwischendemos teilnehmen, ist der wichtigste Faktor dafür, dass das Modell zum tatsächlichen Bedarf passt.
Bei Projekten mit personenbezogenen Daten planen wir KVKK-Konformität, Datenminimierung und Zugriffsrechte von Anfang an ein. Bei Entscheidungsunterstützungssystemen achten wir darauf, dass nachvollziehbar bleibt, worauf das Modell seine Ergebnisse stützt. Kritische Entscheidungen, die eine menschliche Freigabe erfordern, werden nicht automatisiert.
Wir entwickeln Anwendungen wie Qualitätskontrolle, Bedarfsprognose, Dokumentenverarbeitung und Kundenanalyse für Produktion, Handel, Logistik, Dienstleistung und öffentlichen Sektor. Da Daten und Risiken je Branche verschieden sind, entwerfen wir die Lösung nach Analyseergebnissen statt nach einem fertigen Paket.
Entdecken
Eigenständige F&E-Projekte mit wissenschaftlicher Methode – von akademischem Wissen zum technologischen Produkt.
Ansehen AutomatisierungWir machen wiederkehrende Arbeit zu intelligenten Workflows und steigern so Effizienz und Tempo.
Ansehen ERPSkalierbare ERP-Software, die genau zu Ihren Prozessen passt.
AnsehenWie können wir Ihnen helfen?
Software-SupportBestehende Software und technischer Support ProjektunterstützungNeue Projekte, Angebote und BeratungAn Werktagen antworten wir schnell.
 KI-Anwendungen
 KI-Anwendungen
 VR- / AR-Anwendungen